Cần bao nhiêu VRAM để chạy Llama 3.1 70B?
Tính riêng trọng số, KV cache và overhead; ví dụ context 8K, 32K và 128K với cache FP16.
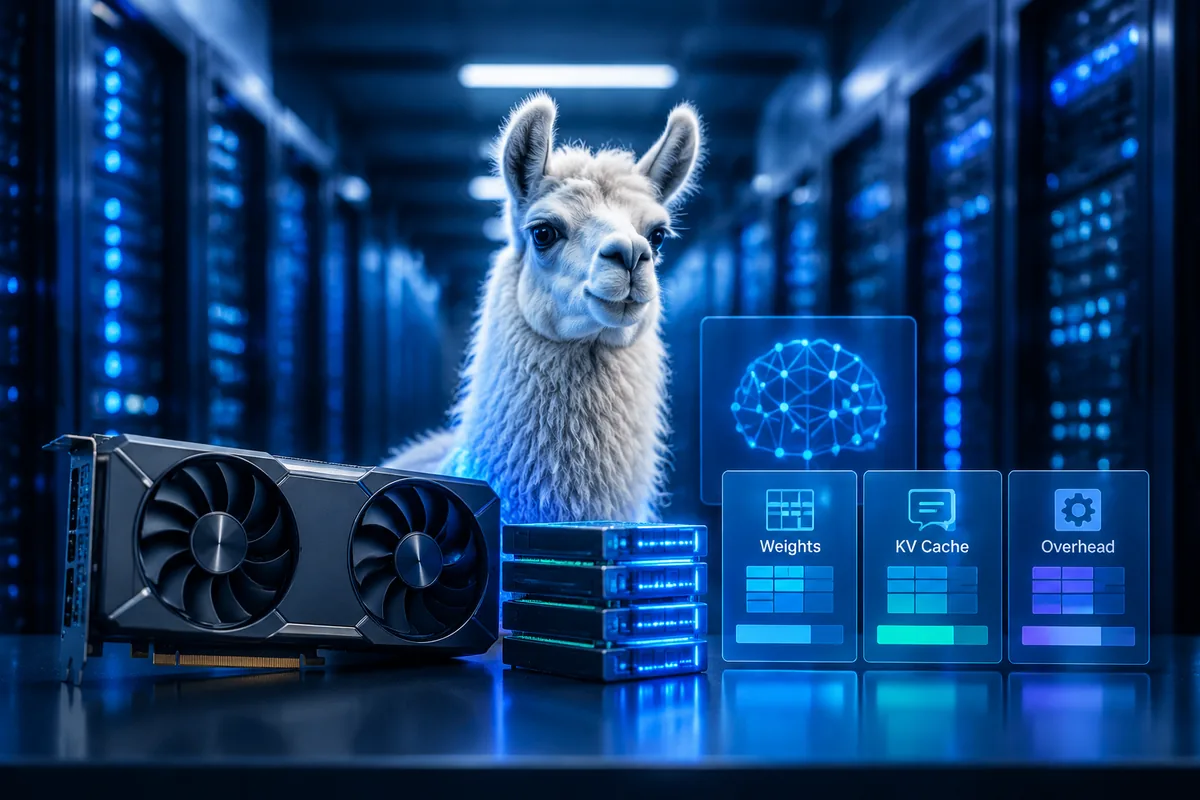
VRAM để chạy Llama 3.1 70B gồm trọng số, KV cache và bộ nhớ phục vụ tính toán. Dung lượng file model chỉ là điểm bắt đầu: context dài và nhiều request đang xử lý có thể khiến hệ thống hết VRAM dù model nạp thành công.
Ước tính riêng phần trọng số
| Precision lý tưởng | Phép tính với 70 tỷ tham số | Dung lượng thập phân |
|---|---|---|
| FP16/BF16 | 70 tỷ × 2 byte | 140 GB |
| 8-bit | 70 tỷ × 1 byte | 70 GB |
| 4-bit | 70 tỷ × 0,5 byte | 35 GB |
Bảng là phép tính lý tưởng, không phải dung lượng checkpoint hay VRAM đo được. Metadata lượng tử hóa, tensor giữ precision cao hơn và framework làm kết quả khác đi. GB thập phân cũng khác GiB; cần dùng cùng đơn vị khi so với GPU.
Tính KV cache đúng với grouped-query attention
Đối với cache đầy đủ của kiến trúc attention thông thường có GQA, bộ nhớ cache gần đúng theo byte = 2 × số layer × số KV head × head dimension × tổng token đang lưu × byte mỗi phần tử. Dùng số KV head thay vì toàn bộ hidden size. Tổng token gồm prompt và token đã sinh của các sequence đang hoạt động.
Cấu hình Llama 3.1 70B dùng 80 layer, 8 KV head và head dimension 128. Với cache FP16, mỗi token cần khoảng 327.680 byte, tức 320 KiB, trước overhead và thay đổi do engine.
| Token cache của một sequence | KV cache FP16 xấp xỉ |
|---|---|
| 8.192 | 2,5 GiB |
| 32.768 | 10 GiB |
| 131.072 | 40 GiB |
Ví dụ bốn sequence cùng giữ 8.192 token cần khoảng 10 GiB KV cache. Đây là phép tính từ cấu hình, không phải benchmark. Prefix sharing, cách cấp phát block, tensor parallel và precision cache có thể làm mức dùng thực tế khác đi.
Vì sao một RTX 5090 không đủ chứa toàn bộ 70B 4-bit phổ biến?
Một GPU 32 GB nhỏ hơn ngay phần trọng số 4-bit lý tưởng 35 GB của 70 tỷ tham số, chưa tính cache. Vì vậy không nên mặc định một RTX 5090 có thể giữ toàn bộ 70B 4-bit trong VRAM. Offload sang RAM hoặc phương pháp nén khác có thể cho phép chạy, nhưng đặc tính hiệu năng và chất lượng cần đánh giá riêng.
Nhiều GPU không tự động tạo một vùng nhớ chung
Hai card 24 GB chỉ hữu ích cho model lớn nếu engine hỗ trợ chia model và từng card còn đủ headroom cho phân vùng của nó. Phải kiểm tra topology PCIe, khả năng truyền giữa GPU, phương pháp parallel và phiên bản phần mềm. Tổng VRAM bằng phép cộng không bảo đảm workload chạy được hay đạt độ trễ mong muốn.
Quy trình chọn cấu hình
- Chốt checkpoint, định dạng lượng tử hóa và engine.
- Đặt giới hạn prompt, output và concurrency cho tải production.
- Ước tính trọng số, KV cache và dành bộ nhớ cho runtime.
- Nạp model, thử prompt ngắn/dài và tải đồng thời đại diện.
- Đo VRAM đỉnh, OOM, thời gian token đầu và tốc độ sinh.
- Điều chỉnh context/concurrency hoặc số GPU rồi thử lại.
Với một GPU 80 GB, phần trọng số 8-bit lý tưởng có thể vừa nhưng không đồng nghĩa còn đủ cache cho context dài hay nhiều request. Với FP16 trên nhiều GPU, cần tính memory theo từng card và overhead thực tế, không chỉ tổng 140 GB.
Xem GPU Server là gì và dịch vụ thuê GPU. Khi gửi yêu cầu cấu hình, cung cấp model, precision, context và số request đồng thời để có phương án kiểm thử phù hợp.
Cache FP8 có luôn giảm một nửa tổng VRAM không?
Không. Nó tác động chủ yếu đến phần KV cache; trọng số và các vùng nhớ khác vẫn cần tính riêng, đồng thời engine phải hỗ trợ cấu hình này.
Model nạp được có nghĩa phục vụ production được không?
Chưa. Cần thử context dài và concurrency mục tiêu, đo OOM cùng độ trễ trước khi nghiệm thu.
Cần GPU cho workload này?
NOC aigpu.vn hỗ trợ chọn GPU, VRAM và cấu hình phù hợp. PoC trong 24 giờ.
Bài viết liên quan
 GPU / AI
GPU Server là gì? Cách chọn GPU cho mô hình ngôn ngữ lớn
Hướng dẫn chọn GPU Server theo workload: bộ nhớ, độ trễ, tải đồng thời và khả năng vận hành ứng dụng AI.
 GPU / AI
RTX 4090 vs RTX 5090 cho AI: VRAM và cách kiểm thử
So sánh 24 GB GDDR6X và 32 GB GDDR7; chọn GPU theo model, tải đồng thời và kết quả kiểm thử ứng dụng.
 GPU / AI
NVIDIA H200 SXM: thông số, phiên bản và mô hình AI
Đội phục vụ mô hình lớn thường hết bộ nhớ trước khi dùng hết tính toán. H200 tăng dư địa chứa trọng số và cache, nên cần đánh giá theo số phiên đồng thời và độ dài tài liệu mà khách gửi vào.